EgoMimic: Học bắt chước từ video góc nhìn thứ nhất
Cách dữ liệu bàn tay ở góc nhìn thứ nhất trở thành nguồn thao tác mẫu để huấn luyện chung, ý nghĩa của xu hướng mở rộng quy mô và giới hạn bằng chứng đằng sau con số 400% được lan truyền.
Camera gắn trên người hoặc robot làm thay đổi dữ liệu ra sao, một cú quay đầu ảnh hưởng thế nào đến định danh vật thể, và vì sao quy tắc xử lý vật thể rời khung hình phải được xác định trước khi gắn nhãn.
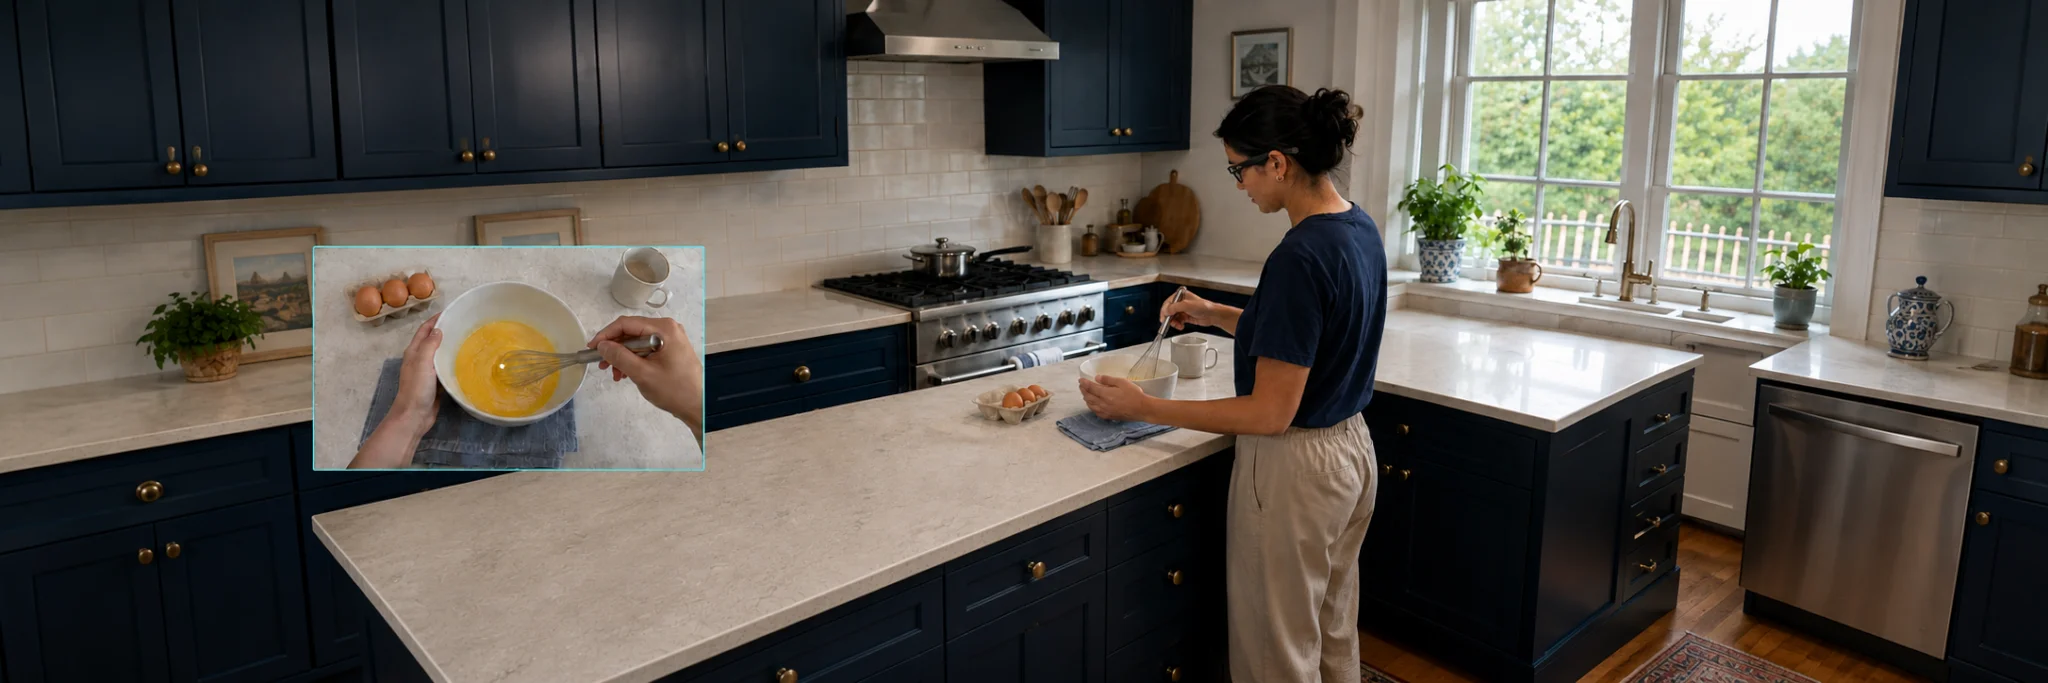
Dữ liệu góc nhìn thứ nhất (egocentric) là dữ liệu cảm biến được ghi từ góc nhìn của chính người đang thực hiện tác vụ, bằng camera đeo trên đầu hoặc gắn trên thân robot. Loại dữ liệu này tồn tại vì góc nhìn từ bên trong tác vụ cho thấy bàn tay, dụng cụ và điểm tiếp xúc ở đúng tỷ lệ mà một chính sách thao tác phải hành động, điều mà camera đặt trên chân máy ở phía bên kia căn phòng không làm được. Đặc tính xác định của nó là camera di chuyển vì người thực hiện di chuyển, nên bản ghi mang theo cả sự chú ý và chuyển động cơ thể bên cạnh khung cảnh. Đó là điều làm nó có giá trị, đồng thời làm nó khó gắn nhãn, vì không có gì trong khung hình đứng yên.
Dữ liệu góc nhìn thứ nhất là bất kỳ luồng dữ liệu nào được ghi lại mà tư thế cảm biến gắn cứng với tác nhân đang thực hiện tác vụ: camera đeo trên đầu một người, camera cổ tay trên cánh tay robot, camera ở đầu của một robot hình người. Hệ quả kỹ thuật là tư thế camera không phải một tham số cố định của bố trí thu thập mà là một tín hiệu biến thiên theo thời gian, do chính hành vi được ghi tạo ra. Đó là lý do các bộ dữ liệu góc nhìn thứ nhất có trang bị đo hình học có thể đi kèm quỹ đạo camera cùng với điểm ảnh, thay vì chỉ một phép hiệu chuẩn ngoại tại duy nhất.
Phạm vi ở đây là góc nhìn và tác động của nó lên dữ liệu. Việc thu thập góc nhìn thứ nhất trên người giao thoa với [[Human Video Data]], vốn bao quát video về con người như một tín hiệu huấn luyện, bất kể được quay từ góc nhìn nào. Mục này bao quát các hệ thống thu thập góc nhìn thứ nhất, họ [[Ego4D]] và trường hợp gắn trên robot, nơi người đeo là một cỗ máy và cùng một hình học được áp dụng. Nó không bao gồm các bản ghi cố định và góc nhìn thứ ba, vốn là nửa góc nhìn ngoài của các bộ dữ liệu ghép cặp.
Hãy xét một bản ghi được thực hiện trên kính [[Project Aria]]. Một người đeo thiết bị và dỡ máy rửa bát trong hai mươi phút. Bản thu thô gồm video RGB cùng các luồng đơn sắc đồng bộ, IMU, âm thanh và theo dõi ánh mắt, và các Dịch vụ Nhận thức Máy (Machine Perception Services) của Meta biến bản thu thô đó thành quỹ đạo vòng kín, đám mây điểm, hiệu chuẩn, ánh mắt và các điểm mốc bàn tay, như [[Project Aria]] mô tả đầy đủ. Một lượt chú thích bổ sung lời thuyết minh, ranh giới đoạn hành động và các track vật thể.
Lỗi nằm ở chỗ các nhãn đó được định nghĩa trong không gian ảnh, mà không gian ảnh lại gắn với một cái đầu đang chuyển động. Giữa lúc với tay, người đeo liếc sang mặt bàn để kiểm tra chỗ đặt chiếc đĩa tiếp theo. Giả sử vật thể mục tiêu rời khỏi trường nhìn trong vài trăm mili giây, một khoảng thời gian được chọn ở đây để ví dụ cụ thể chứ không đo từ một kho dữ liệu nào, rồi quay lại ở tỷ lệ và góc khác. Một bộ theo dõi đã mất nó sẽ bắt lại nó như một thực thể mới, nên một chiếc đĩa trở thành hai trong bản ghi, trong khi một bộ phân đoạn dựa trên lời thuyết minh chưa từng mất nó vẫn giữ một hành động liên tục xuyên qua khoảng trống đó. Hai kênh giờ bất đồng về số vật thể đã được xử lý, và không kênh nào sai theo logic riêng của nó. Ở hạ nguồn, số đếm độ bao phủ cấp vật thể bị thổi phồng, và một chính sách gắn kết ngôn ngữ với thực thể sẽ nhận được hai đối tượng quy chiếu cho cùng một chiếc đĩa.
Quan sát của robot tại thời điểm thực thi. Thực hành thu thập dữ liệu nghiên cứu trên các tay máy robot: hệ thống DROID dùng chung ghép một camera Zed Mini gắn cổ tay với hai camera cảnh Zed 2 điều chỉnh được tại cả 13 tổ chức thu thập (DROID).
Tiền huấn luyện bộ mã hóa thị giác của chính sách trên video góc nhìn thứ nhất của con người. Giai đoạn nghiên cứu, và là lý do họ [[Ego4D]] được trích dẫn trong học robot.
Học đa góc nhìn, trong đó các bản ghi góc nhìn thứ nhất và góc nhìn thứ ba được ghép cặp của cùng một phiên ghi giám sát tính bất biến theo góc nhìn (Ego-Exo4D, 2023). Giai đoạn nghiên cứu.
Tổng hợp góc nhìn cổ tay robot từ video đeo trên đầu của con người, để một chính sách được triển khai từ đúng góc nhìn mà nó sẽ có. Giai đoạn nghiên cứu: WARPED báo cáo mức thành công tương đương các chính sách được huấn luyện trên trình diễn điều khiển từ xa ở năm tác vụ trên mặt bàn, với thời gian thu thập ít hơn 5 đến 8 lần (WARPED, 2026).
Hỗ trợ tương tác và phát hiện lỗi từ một chiếc kính đeo trong lúc sửa chữa (HoloAssist, 2023). Giai đoạn nghiên cứu.
Meta Reality Labs: chương trình nghiên cứu của doanh nghiệp. Project Aria cung cấp phần cứng thu thập và các dịch vụ nhận thức đứng sau phần lớn hoạt động thu thập góc nhìn thứ nhất trong học thuật.
Microsoft Research: phòng nghiên cứu doanh nghiệp. HoloAssist ghi bảy luồng đồng bộ từ một kính thực tế hỗn hợp trong các tác vụ sửa chữa.
University of Bristol: phòng thí nghiệm học thuật, duy trì EPIC-KITCHENS, một bộ chuẩn góc nhìn thứ nhất không kịch bản đã tồn tại lâu năm.
Figure: công ty khởi nghiệp, triển khai thí điểm thương mại. Helix chạy từ các camera đơn mắt trên thân máy, với một mô hình thị giác-ngôn ngữ 7B ở 7 đến 9 Hz điều khiển một chính sách thị giác-vận động 80M ở 200 Hz.
Liên minh DROID: hợp tác học thuật đã chuẩn hóa một giàn gồm camera cổ tay cộng camera cảnh trên 13 tổ chức.
[[Ego4D]]: 3.670 giờ hoạt động đời thường từ 931 người đeo camera tại 74 địa điểm thuộc 9 quốc gia, theo phần tóm tắt trên arXiv (Ego4D, 2021), kèm âm thanh, lưới môi trường 3D, ánh mắt và stereo trên một số tập con.
Ego-Exo4D: 1.286,3 giờ qua 5.035 phiên ghi từ 740 người tham gia tại 13 thành phố và 123 địa điểm, với các góc nhìn thứ nhất và thứ ba được ghi đồng thời, cùng ánh mắt, tư thế camera và đám mây điểm. Các góc nhìn ghép cặp giúp tính bất biến theo góc nhìn đo lường được thay vì chỉ được giả định.
EPIC-KITCHENS-100: 100 giờ hoạt động bếp không kịch bản bằng camera đeo trên đầu tại 45 căn bếp ở 4 thành phố, được phân đoạn thành khoảng 90.000 đoạn hành động trên 97 lớp động từ và 300 lớp danh từ.
HoloAssist: 166 giờ từ 350 cặp người hướng dẫn và người thực hiện, mang theo cả việc chỉnh sửa và can thiệp chứ không chỉ các lần thực thi thành công.
DROID: 76.000 quỹ đạo và 350 giờ trên 564 cảnh và 86 tác vụ, với hiệu chuẩn cho 1.417 góc nhìn. Luồng góc nhìn thứ nhất của nó là camera cổ tay.
WARPED: Wrist-Aligned Rendering for Robot Policy Learning from Egocentric Human Demonstrations (2026)
Active Vision Might Be All You Need: Exploring Active Vision in Bimanual Robotic Manipulation (2024)
Ego-Exo4D: Understanding Skilled Human Activity from First- and Third-Person Perspectives (2023)
HoloAssist: an Egocentric Human Interaction Dataset for Interactive AI Assistants in the Real World (2023)
Vision-Based Manipulators Need to Also See from Their Hands (2022)
Ego4D: Around the World in 3,000 Hours of Egocentric Video (2021)
[[Project Aria]] là thiết bị thu thập dữ liệu góc nhìn thứ nhất của con người phục vụ nghiên cứu. Bài viết này chưa xác lập liệu thiết bị đó có phải là chuẩn nghiên cứu hay không; thông số từng cảm biến, những thay đổi giữa Gen 1 và Gen 2 cùng đầu ra nhận thức trên thiết bị của nó được trình bày ở đó thay vì nhắc lại ở đây. Điều quan trọng với mục này là phần cứng ấy giải quyết điều gì: cảm biến màn trập toàn cục và dải động rộng đáp ứng hai điều kiện mà việc thu thập góc nhìn thứ nhất gây ra thường xuyên hơn thu thập cố định, đó là cú xoay đầu nhanh và người đeo đi từ căn phòng sáng vào chỗ tối ngay trong một tập ghi.
Về phía robot, tương đương là camera cổ tay như Zed Mini trên hệ thống DROID, hoặc camera ở đầu của một robot hình người. Lựa chọn thứ ba là một camera được điều khiển chủ động. Một nghiên cứu đã gắn một chiếc ZED Mini lên một cánh tay 7 bậc tự do bổ sung, được điều khiển theo chuyển động đầu của người vận hành qua kính VR, với chi phí phần cứng tăng thêm ước tính 6.600 USD, và báo cáo mức thành công cao hơn so với chỉ dùng camera tĩnh trong các tác vụ nhiều che khuất, gồm 52% so với 30% ở việc xỏ kim (Chuang et al., 2024). Đó là kết quả của nghiên cứu ấy trên nền tảng hai tay ấy.
projectaria_tools là trình đọc tham chiếu cho các bản ghi Aria và là giao diện đến Machine Perception Services, nơi quỹ đạo camera, đám mây điểm, ánh mắt và các điểm mốc bàn tay được tạo ra. Ngoài ra, các quy trình góc nhìn thứ nhất được lắp ghép theo từng dự án, và những thành phần quan trọng là những thành phần dùng đến tư thế camera: một khâu SLAM hoặc VIO, một bộ theo dõi phải trụ được qua các lần vật thể rời khung hình, và một bộ ghi xuất các tập vào định dạng dữ liệu mà hệ thống huấn luyện mong đợi. [[Multimodal Dataset Synchronization]] quyết định liệu các luồng dữ liệu được suy ra đó có khớp với video hay không.
Về phía robot, câu hỏi về góc nhìn phần lớn đã ngã ngũ đối với các nền tảng được mô tả ở đây, trong khi vị trí đặt camera vẫn là một bài toán nghiên cứu đang diễn ra. Một nghiên cứu có hệ thống trên nhiều thuật toán học, trong mô phỏng và trên phần cứng thực, cho thấy góc nhìn lấy bàn tay làm trung tâm cải thiện hiệu quả huấn luyện và khả năng khái quát hóa ngoài phân phối một cách nhất quán, với điều kiện là chỉ khi góc nhìn bàn tay đủ quan sát được, và việc thêm luồng góc nhìn thứ ba để khôi phục khả năng quan sát lại làm giảm khả năng khái quát hóa lần nữa (Hsu et al., 2022). Các nền tảng nghiên cứu dùng chung cũng phản ánh xu hướng này: DROID chuẩn hóa một camera cổ tay cộng hai camera cảnh tại cả 13 tổ chức thu thập, và Helix của Figure chỉ chạy từ các camera trên thân máy (DROID, Figure, 2025). Góc nhìn thứ ba dùng để làm gì vẫn còn tranh cãi.
Về phía con người, việc thu thập và các đầu ra nhận thức được suy ra đã trưởng thành nhanh hơn các quy ước chú thích xây trên chúng. Aria Gen 2 cung cấp ánh mắt, điểm mốc bàn tay và quỹ đạo camera 1 kHz dưới dạng dịch vụ, trong khi các lược đồ nhãn trên dữ liệu đó vẫn đến từ lĩnh vực hiểu video: lời thuyết minh, đoạn hành động, nhãn hành động (verb) và nhãn đối tượng (noun), được định nghĩa dựa trên các khung hình thay vì dựa trên cảnh đã được tái dựng (EPIC-KITCHENS-100, Ego4D, 2021). Ego-Exo4D là phản ứng dễ thấy, ghép mỗi phiên ghi với các góc nhìn thứ ba đồng thời để một nhận định về góc nhìn có thể được kiểm chứng (Ego-Exo4D).
Bài viết này chưa xác lập liệu thực tiễn bảo vệ quyền riêng tư đã nghiêng về hướng hạn chế hay chưa. [[Ego4D]] được thu thập hoặc trong môi trường có kiểm soát với sự đồng ý có hiểu biết, hoặc ở nơi công cộng với khuôn mặt và thông tin nhận dạng cá nhân khác được làm mờ, và 612 giờ chỉ được phát hành không làm mờ ở nơi người tham gia đã đồng ý riêng điều đó (Ego4D privacy statement). Đó là một mẫu hình được ghi nhận chứ không phải khuôn mẫu mà cả lĩnh vực đều theo, và ở nơi không có môi trường kiểm soát, một bộ dữ liệu được ghi tại nhà và nơi làm việc phải gánh việc che giấu thông tin như một chi phí thường trực chứ không phải một bước làm một lần.
Nhãn mất tính nhất quán khi vật thể rời khung hình. Một vật thể rời tầm nhìn khi người đeo quay đầu rồi xuất hiện trở lại được người thuyết minh coi là một vật thể, nhưng bộ theo dõi coi là hai. Các chỉ số chất lượng theo từng khung hình không phát hiện được bất đồng này vì mỗi kênh vẫn nhất quán khi xét riêng.
Bị chính cơ thể người thực hiện che khuất. Bàn tay bị che khuất nhiều nhất đúng lúc nắm lấy vật thể, cũng là thời điểm mà nhãn tiếp xúc cần mô tả.
Quyền riêng tư của người xung quanh là vấn đề xuyên suốt quá trình ghi hình. Camera đeo trên người trong nhà hoặc kho hàng ghi lại tất cả những ai đi ngang. Sự đồng ý của người đeo không tự động đồng nghĩa với sự đồng ý của những người đó.
Nhãn phụ thuộc vào tư thế camera, chứ tư thế không chỉ là siêu dữ liệu. Độ chính xác của mọi nhãn 3D và mọi phép so sánh giữa các phiên ghi đều phụ thuộc vào quỹ đạo camera. Vì vậy, lỗi SLAM âm thầm làm giảm chất lượng của mọi nhãn được suy ra trong khoảng thời gian đó, thay vì tự báo hiệu.
Góc nhìn khi thu thập hiếm khi trùng với góc nhìn khi triển khai. Camera đeo trên đầu người và camera cổ tay robot nhìn thấy những đối tượng khác nhau ở các tỷ lệ khác nhau. Đó là khoảng cách mà hướng nghiên cứu đa góc nhìn tìm cách thu hẹp (WARPED, 2026).
Kotwel là đối tác về chất lượng và vận hành dữ liệu cho AI Vật lý (Physical AI). Chúng tôi chuyển đổi dữ liệu đa phương thức từ thế giới thực và dữ liệu tổng hợp thành các bộ dữ liệu được đồng bộ, cấu trúc hóa, kiểm định chất lượng và có khả năng truy xuất nguồn gốc, phục vụ việc huấn luyện, đánh giá và cải tiến liên tục. Chúng tôi xác định rõ các quy ước và lựa chọn có ảnh hưởng đến chất lượng dữ liệu, đồng thời xây dựng các tiêu chí chất lượng có thể đo lường, làm cơ sở để các tổ chức đánh giá và cải thiện dữ liệu cho các hệ thống AI Vật lý.
Kotwel tập trung vào tầng dữ liệu, không phụ thuộc vào một nền tảng phần cứng, hệ thống cảm biến hay dòng mô hình AI cụ thể nào. Chúng tôi xây dựng tiêu chí chất lượng, kiểm tra dữ liệu và đánh giá mức độ đáp ứng các yêu cầu đã thống nhất. Khách hàng quyết định các quy ước riêng của dự án, hành vi mong muốn của mô hình và yêu cầu vận hành, miễn là các yêu cầu này được ghi rõ và áp dụng nhất quán. Kotwel không chế tạo robot, phát triển hệ thống tự hành hoặc điều khiển, hay huấn luyện mô hình nền tảng. Các quyết định về an toàn, pháp lý và triển khai hệ thống thuộc trách nhiệm của khách hàng.
Câu hỏi về đặc tả xuất hiện ngay lần đầu tiên một vật thể rời khung hình rồi quay lại. Một người đeo với tay lấy chiếc đĩa liếc sang bên đủ lâu để chiếc đĩa rời khỏi khung hình, và hướng dẫn phải nói rõ chiếc đĩa trước cái liếc và chiếc đĩa sau đó là một thực thể được gắn nhãn xuyên suốt hay hai thực thể riêng biệt. Cả hai cách diễn giải đều có cơ sở. Nếu gắn nhãn theo danh tính trong thế giới, bản ghi khẳng định sự liên tục qua một khoảng mà không khung hình nào chứng thực, và che giấu việc mức độ người gắn nhãn phải suy luận thay vì dựa trực tiếp vào quan sát. Nếu gắn nhãn theo quan sát, mọi nhãn đều dựa trên bằng chứng nhìn thấy được, với cái giá là một bản ghi bị phân mảnh, trong đó số đếm tiếp xúc, thống kê độ bao phủ và gắn kết ngôn ngữ cho ra kết quả sai mà không ai nhận ra cho đến khi một policy nhận hai định danh cho cùng một chiếc đĩa. [[Ego4D]] ghi nhận các lời thuyết minh văn bản tự do theo thời gian, trong khi EgoTracks chú thích riêng các track vật thể dài hạn trên video Ego4D. Kotwel làm việc trên đặc tả đó: làm tường minh các quy tắc của chương trình về một thực thể là gì qua các lần rời khung hình, thế nào là một track hợp lệ khi tư thế camera là một phần của tín hiệu, và người chú thích phải có bằng chứng gì trước khi khẳng định sự liên tục, đồng thời thực hiện việc rà soát phát hiện khi một bộ dữ liệu đang lệch khỏi các quy tắc đã được xác định.
Dữ liệu góc nhìn thứ nhất được xác định bởi việc camera gắn trên tác nhân, khiến tư thế camera là một tín hiệu do hành vi tạo ra thay vì một thuộc tính cố định của bố trí thu thập.
Trên robot, một nghiên cứu có hệ thống cho thấy góc nhìn lấy bàn tay làm trung tâm cải thiện hiệu quả huấn luyện và khả năng khái quát hóa ngoài phân phối trên các thuật toán được khảo sát, cả trong mô phỏng lẫn trên robot thực, nhưng chỉ khi góc nhìn đó cho phép quan sát đầy đủ. Nếu không, cần thêm góc nhìn thứ ba, và việc bổ sung này làm giảm khả năng khái quát hóa ngoài phân phối.
Trên con người, việc thu thập và các đầu ra nhận thức được suy ra đã vượt trước các quy ước chú thích, vốn vẫn được định nghĩa dựa trên khung hình thay vì cảnh đã được tái dựng.
Lỗi gắn nhãn đặc trưng là danh tính qua các lần vật thể rời khung hình, và nó vô hình đối với các kiểm tra chất lượng theo từng khung hình vì kênh thuyết minh và kênh theo dõi có thể mỗi bên tự nhất quán trong khi bất đồng với nhau.
Quyền riêng tư của người xung quanh là chi phí thường trực của việc thu thập bằng thiết bị đeo, và khuôn mẫu của Ego4D là sự đồng ý trong môi trường có kiểm soát hoặc làm mờ ở nơi công cộng.
Không. Góc nhìn thứ nhất mô tả vị trí đặt camera, còn video con người mô tả ai đang ở trước camera. Một camera cổ tay robot tạo ra dữ liệu góc nhìn thứ nhất mà không có con người trong vòng lặp, và một chân máy cố định quay một người đang nấu ăn là video con người nhưng không phải góc nhìn thứ nhất. Chúng giao nhau trong thực tế vì các bộ dữ liệu góc nhìn thứ nhất công khai lớn tình cờ đều là bản ghi về con người, đó là lý do một bộ dữ liệu chỉ được mô tả là góc nhìn thứ nhất không cho bạn biết gì về việc nó có chứa các hành động mà robot dùng được hay không.
Cần cả hai, trên các hệ thống nghiên cứu dùng chung được mô tả trong bài này, trong đó camera cổ tay mang chi tiết thao tác. Nghiên cứu so sánh có hệ thống cho thấy góc nhìn lấy bàn tay làm trung tâm cải thiện hiệu quả huấn luyện và khả năng khái quát hóa ngoài phân phối trên nhiều thuật toán và bối cảnh, nhưng chỉ khi góc nhìn bàn tay tự nó đủ quan sát được, và việc thêm góc nhìn thứ ba để khôi phục khả năng quan sát lại làm mất bớt khả năng khái quát hóa (Hsu et al., 2022). Nền tảng DROID dùng chung đã chốt một camera cổ tay cộng hai camera cảnh điều chỉnh được (DROID).
Không có chi phí theo giờ nào được công bố cho việc này, vì yếu tố quyết định là mật độ nhãn chứ không phải thời lượng. EPIC-KITCHENS-100 cho biết bậc độ lớn ở đầu dày đặc là khoảng 900 đoạn hành động mỗi giờ, từ khoảng 90.000 đoạn trên 100 giờ, chưa tính bất kỳ track vật thể, hiệu chỉnh tư thế bàn tay hay chú thích 3D nào đặt thêm lên trên (EPIC-KITCHENS-100). Điều làm con số thay đổi là bạn gắn nhãn bao nhiêu kênh, danh tính có phải được mang qua các lần rời khung hình hay không, và bạn xác minh bao nhiêu phần các đầu ra nhận thức được suy ra thay vì tin vào nó.
Vì góc nhìn gắn trên đầu di chuyển với tốc độ của đầu, nên vật thể liên tục rời khỏi rồi quay lại khung hình ở tỷ lệ và góc thay đổi. Chuyển động đầu phá vỡ giả định rằng vật thể vẫn ở gần vị trí trước đó trong ảnh, và các bộ theo dõi 2D hiện có hoạt động kém trên dữ liệu góc nhìn thứ nhất. Một nghiên cứu đã cải thiện kết quả bằng cách dùng tư thế camera để nhận diện lại vật thể. Hiệu năng theo dõi và tính nhất quán của nhãn là hai vấn đề riêng biệt; quy tắc gắn nhãn chỉ giải quyết vấn đề thứ hai: quyết định trước việc quay lại có tạo ra một thực thể mới hay không, và ghi lại kênh nào, bộ theo dõi hay lời thuyết minh, có thẩm quyền về danh tính. Thiếu quy tắc đó, hai kênh sẽ bất đồng một cách lặng lẽ và bộ dữ liệu ghi nhận nhiều vật thể riêng biệt hơn số vật thể thực tế.