AI Vật Lý
Cách trí thông minh được học chuyển thành hành động vật lý, vì sao chuyển trạng thái khiến dữ liệu robot trở nên phức tạp, và cách hành vi robot dịch chuyển từ mã được thiết kế sang dữ liệu cùng tham số học.
Cách dữ liệu bàn tay ở góc nhìn thứ nhất trở thành nguồn thao tác mẫu để huấn luyện chung, ý nghĩa của xu hướng mở rộng quy mô và giới hạn bằng chứng đằng sau con số 400% được lan truyền.
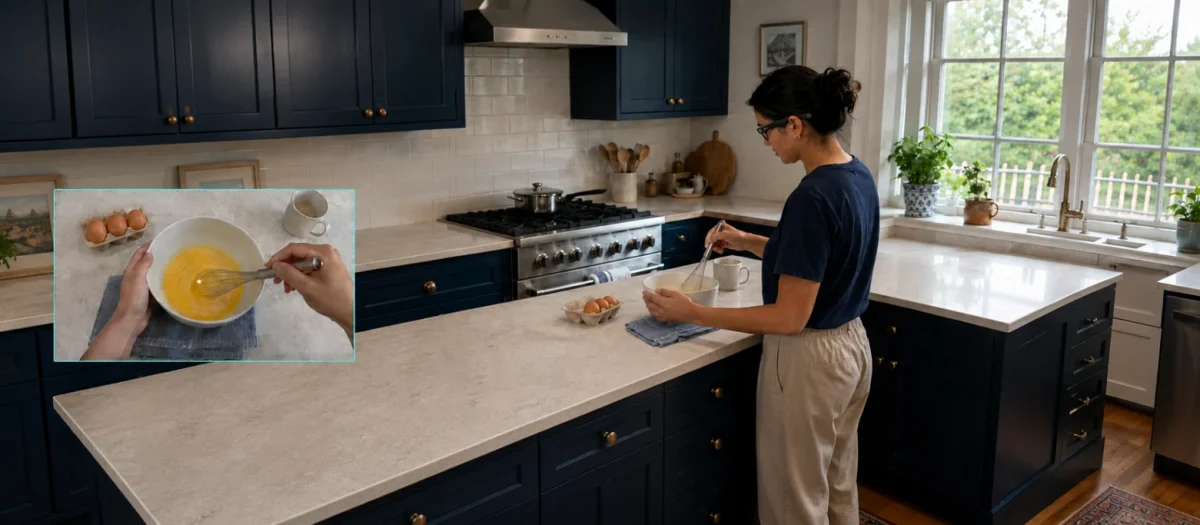
EgoMimic là một framework học cho robot do Georgia Tech giới thiệu năm 2024, huấn luyện một chính sách thao tác đồng thời trên hai nguồn: video góc nhìn thứ nhất của con người có theo dõi bàn tay 3D và dữ liệu thao tác mẫu của robot được điều khiển từ xa. Công trình có ý nghĩa với AI Vật Lý (Physical AI) vì đã công bố thử nghiệm trên ba tác vụ thực tế, trong đó dữ liệu bàn tay người được dùng như một nguồn thao tác mẫu độc lập, thay vì chỉ làm đầu vào cho tiền huấn luyện hoặc lập kế hoạch. Kết quả nổi bật của công trình cũng so sánh số giờ dữ liệu, thay vì chỉ đưa ra một tỷ lệ thành công.
EgoMimic: Mở rộng quy mô học bắt chước bằng video góc nhìn thứ nhất do Simar Kareer, Dhruv Patel, Ryan Punamiya, Pranay Mathur, Shuo Cheng, Chen Wang, Judy Hoffman và Danfei Xu thực hiện. Theo bài báo, bảy trong tám tác giả ghi đơn vị công tác là Georgia Institute of Technology, còn Chen Wang ghi Stanford. Bài được gửi lên arXiv ngày 31 tháng 10 năm 2024, và một công trình sau đó trích dẫn bài này là công trình tại ICRA 2025.
Mã nguồn hiện ở mức phục vụ nghiên cứu. Kho mã công khai chứa mã xử lý dữ liệu và huấn luyện cho cả dữ liệu người thu bằng Aria lẫn dữ liệu robot điều khiển từ xa. README liệt kê các tệp dữ liệu người và robot cho ba tác vụ được đánh giá, lưu trên Hugging Face dưới tổ chức gatech (kiểm tra ngày 3 tháng 10 năm 2026). Bài báo cũng cho biết sẽ công bố danh mục vật tư của robot. Ghi chú này chưa xác minh giấy phép của kho mã hay các tài liệu phần cứng.
Bài báo mô tả bốn thành phần hợp thành một framework bao quát toàn bộ hệ thống, theo cách gọi của các tác giả.
Thu dữ liệu người. Hệ thống dựa trên kính Project Aria, có khối lượng 75 g theo bài báo. Camera RGB phía trước cung cấp hình ảnh quan sát; hai camera quan sát môi trường ở hai bên phục vụ ước lượng tư thế thiết bị và theo dõi bàn tay. Nhờ đó, bàn tay vẫn được theo dõi khi ra khỏi vùng nhìn của camera RGB. Machine Perception Services trên đám mây của Aria trả về tư thế thiết bị từ SLAM, vị trí bàn tay và các ước lượng khác. Các tác giả chuyển những đầu ra này thành tệp huấn luyện robomimic.
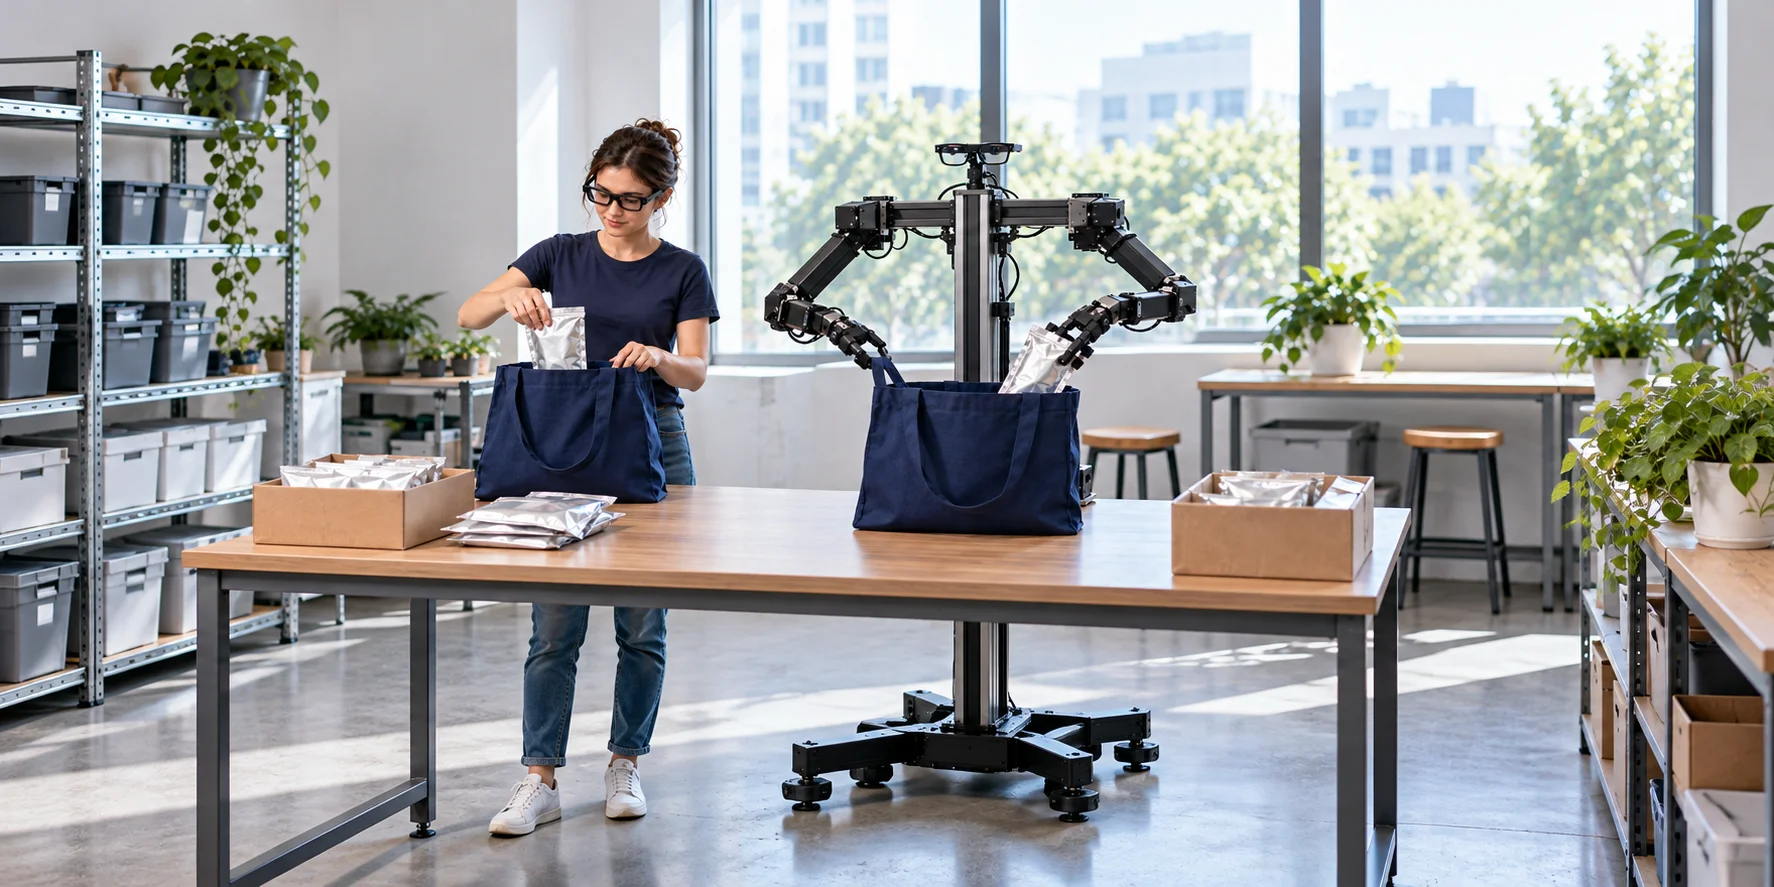
Robot chi phí thấp. Hai tay máy ViperX 300 S 6-DoF, gắn camera RealSense D405 ở cổ tay, được lắp trên một khung có thể điều chỉnh độ cao để tạo phần thân robot. Theo bài báo, khung này có giá dưới $1,000, chưa tính các tay máy. Một cặp kính Aria thứ hai làm camera chính của robot, loại bỏ khác biệt về phần cứng camera giữa dữ liệu người và robot.
Căn chỉnh giữa hai miền dữ liệu. Quỹ đạo bàn tay và bộ phận chấp hành cuối được chuyển sang hệ tọa độ camera tại bước thời gian hiện tại. Tư thế và hành động được chuẩn hóa Gaussian riêng cho từng nguồn. Cả bàn tay lẫn tay máy đều được che bằng mặt nạ tạo bởi SAM và phủ một đường màu đỏ để giảm khác biệt về hình ảnh. Dữ liệu người còn được làm chậm 4 lần, để khoảng dự đoán một giây của người tương ứng với khoảng dự đoán bốn giây của robot; dữ liệu người được ghi ở 30 Hz và dữ liệu robot ở 50 Hz.
Chính sách thống nhất. Kiến trúc mở rộng Action Chunking with Transformers, dùng chung bộ mã hóa và transformer, kết hợp với các nhánh đầu vào và đầu ra ít tầng riêng cho từng nguồn. Hàm mất mát tư thế cung cấp tín hiệu giám sát cho cả dữ liệu người và robot, còn hàm mất mát hành động khớp chỉ giám sát dữ liệu robot. Robot được điều khiển trong không gian khớp vì điều khiển trong không gian Cartesian gặp các cấu hình kỳ dị trên tay máy 6-DoF.
Đánh giá bao gồm ba tác vụ nhiều bước: liên tục đặt vật vào bát, gấp quần áo và đóng gói đồ tạp hóa, với số lượt chạy đánh giá lần lượt là 45, 40 và 50. Trong kết quả của bài báo, EgoMimic cải thiện điểm tác vụ từ 34 đến 228% so với Action Chunking with Transformers, với mức tăng lớn nhất ở tác vụ đặt vật vào bát (từ 39 lên 128 điểm). Tỷ lệ thành công tăng từ 8 đến 33 điểm phần trăm so với mô hình cơ sở đó. So với EgoMimic được huấn luyện không có dữ liệu người, điểm tác vụ tăng từ 10 đến 88% và tỷ lệ thành công tăng từ 2 đến 15 điểm phần trăm. Với màu áo chưa từng thấy, mô hình cơ sở đạt tỷ lệ thành công 25%, còn EgoMimic đạt 85%. Trong một bối cảnh mới, không bổ sung dữ liệu robot, EgoMimic đạt 63 điểm, so với 4 điểm của mô hình cơ sở MimicPlay.
Kết quả về mở rộng quy mô chỉ đến từ tác vụ đặt vật vào bát. EgoMimic được huấn luyện với 2 giờ dữ liệu robot cộng 1 giờ dữ liệu bàn tay đạt 128 điểm, trong khi mô hình cơ sở được huấn luyện với 3 giờ dữ liệu robot đạt 74 điểm. Theo bài báo, một giờ thu dữ liệu người tạo ra 1,400 lượt thao tác mẫu, còn một giờ thu dữ liệu robot tạo ra khoảng 135 lượt. Các tác giả cũng lưu ý rằng với 2 giờ dữ liệu robot, EgoMimic đã vượt mô hình cơ sở dùng cùng 2 giờ dữ liệu. Vì vậy, một phần chênh lệch đến từ kiến trúc, thay vì từ dữ liệu người.
Lập luận của bài báo tập trung vào vị trí đưa dữ liệu người vào quy trình. Những phương pháp trước đó được các tác giả dẫn lại dùng video người để huấn luyện bộ lập kế hoạch cấp cao. Bộ này cung cấp điều kiện cho chính sách cấp thấp vốn chỉ được huấn luyện trên dữ liệu robot. EgoMimic đưa cả mẫu người lẫn mẫu robot qua cùng một mạng. Các tác giả xem kết quả trong bối cảnh mới (63 điểm so với 4 điểm của mô hình cơ sở phân cấp do họ triển khai lại) là bằng chứng cho thấy biểu diễn dùng chung khái quát hóa tốt hơn cách tách bộ lập kế hoạch và chính sách. Đây chỉ là một phép so sánh trên một tác vụ, nên kết quả ủng hộ lựa chọn thiết kế này nhưng chưa đủ để kết luận dứt khoát.
Công trình cũng cho thấy dữ liệu người trong riêng hệ thống này gồm những gì. Tín hiệu hành động của dữ liệu người là tư thế bàn tay do một dịch vụ nhận thức ước lượng, nên quy trình mà bài báo mô tả không có nhãn do con người gán. Trong quy trình đó, chất lượng tư thế, độ chính xác của SLAM, việc căn chỉnh dấu thời gian và chất lượng mặt nạ trực tiếp quyết định chất lượng tín hiệu huấn luyện. Đây là nội dung thực tiễn gắn với Human Video Data, Dữ Liệu Góc Nhìn Thứ Nhất (Egocentric Data) và Ước Lượng Tư Thế Bàn Tay Cho Học Robot (Hand Pose Estimation for Robot Learning). Công trình chưa kiểm tra liệu các hệ thống thu dữ liệu góc nhìn thứ nhất khác có cần cùng bốn phép kiểm tra này hay không.
Lợi thế về tốc độ thu dữ liệu phụ thuộc vào tác vụ. Bảng thu dữ liệu của bài báo ghi nhận 23 lượt thao tác mẫu của người mỗi phút, so với 2 lượt của robot ở tác vụ đặt vật vào bát. Với tác vụ đồ tạp hóa, con số chỉ là 2 so với 1; các tác giả cho rằng việc phải đặt lại trạng thái ban đầu khiến thu dữ liệu người chậm hơn.
EgoMimic sử dụng Project Aria để thu dữ liệu người và làm camera của robot. Hệ thống sử dụng Human Video Data, Dữ Liệu Góc Nhìn Thứ Nhất và Dữ Liệu Thao Tác Mẫu Của Robot (Robot Demonstration Data) làm hai nguồn huấn luyện. Hệ thống cũng áp dụng Behavior Cloning dưới dạng chính sách dự đoán chuỗi hành động, và dùng đầu ra của Ước Lượng Tư Thế Bàn Tay Cho Học Robot làm tín hiệu hành động của người. EgoMimic có liên hệ với Teleoperation Interfaces for Data Collection vì dữ liệu robot đến từ một hệ thống tay máy dẫn và tay máy theo; với Data Scaling Laws in Imitation Learning vì cả hai cùng nghiên cứu cách thành phần dữ liệu ảnh hưởng đến hiệu năng chính sách; và với Ego4D, được các tác giả dẫn ra như một dạng bộ dữ liệu góc nhìn thứ nhất quy mô lớn mà framework của họ hướng tới kết hợp.
Mọi kết quả ở đây đều đến từ một phòng thí nghiệm, ba tác vụ và một nền tảng robot được chế tạo riêng, có động học tay tương tự con người, với 40 đến 50 lượt chạy mỗi tác vụ. Các bảng được đọc để viết ghi chú này chỉ báo cáo từng giá trị riêng lẻ, không kèm khoảng tin cậy. Vì vậy, chỉ từ dữ liệu được báo cáo, chưa thể phân biệt những chênh lệch nhỏ, như tỷ lệ thành công 30% so với 28% ở tác vụ đồ tạp hóa, với nhiễu. Mỗi chính sách chỉ phục vụ một tác vụ. Các tác giả liệt kê khả năng khái quát hóa sang robot có cấu hình cơ thể khác và sang hành vi chỉ xuất hiện trong dữ liệu người, như gấp quần dài, là hướng nghiên cứu tương lai; những trường hợp này chưa được thử nghiệm.
Xu hướng khi mở rộng quy mô được đo ở tác vụ đặt vật vào bát với một cách phối trộn dữ liệu. Bài báo chưa kiểm tra liệu một giờ dữ liệu bàn tay có giá trị hơn một giờ dữ liệu robot ở tác vụ khác, hoặc khi lượng dữ liệu robot lớn hơn hay không. Mô hình cơ sở MimicPlay được các tác giả triển khai lại trên cùng kiến trúc transformer nền, không có điều kiện mục tiêu, nên khác với hệ thống gốc. Các thí nghiệm loại bỏ thành phần khảo sát việc tạo mặt nạ, chuẩn hóa hành động và dữ liệu bàn tay, nhưng không tách riêng tác động của việc dùng cùng phần cứng camera.
Dữ liệu người không chứa thông tin nắm bắt, vì Aria chỉ ghi tư thế bàn tay. Trong phụ lục, thao tác nắm bắt chỉ được giám sát qua hàm mất mát khớp của robot. Ví dụ thất bại mà các tác giả đưa ra có trường hợp không nắm được quai túi trong tác vụ đồ tạp hóa.
Con số 400% cần được xem xét riêng. Bài blog của Meta về công trình nói tác giả chính đã “cải thiện hiệu năng robot của mình 400% trên nhiều tác vụ so với các phương pháp trước đó” với “chỉ 90 phút ghi hình bằng Aria”. Bài báo về bộ dữ liệu thử nghiệm Aria Gen 2 của Meta cũng lặp lại con số này. Trong nội dung arXiv được đọc để viết ghi chú này, kể cả phụ lục, mức tăng điểm tương đối lớn nhất là 228%, phần mở đầu nói tối đa 200%, và dữ liệu người được thu cho từng tác vụ là 60, 80 và 100 phút, không có tác vụ nào là 90 phút. Lần kiểm tra bổ sung ngày 2026-10-11 không tìm thấy quy trình thí nghiệm làm cơ sở cho con số này ở những nơi khác được nêu. Trang thông tin arXiv chỉ có một phiên bản (v1, ngày 31 tháng 10 năm 2024), nên không có bản sửa đổi arXiv nào về sau để giải thích khác biệt. Trang dự án không nêu tỷ lệ phần trăm hay con số 90 phút, mà chỉ so sánh 2 giờ dữ liệu robot cộng 1 giờ dữ liệu bàn tay với 3 giờ dữ liệu robot. Bản cuối cùng để xuất bản tại ICRA 2025 chưa được mở đọc, nên vẫn chưa được kiểm tra. Blog so sánh với “các phương pháp trước đó” không được nêu tên, thay vì mô hình cơ sở dự đoán chuỗi hành động trong bài báo. Vì thế, con số này có thể dựa trên một thí nghiệm hoặc thước đo khác. Ghi chú này chưa xác định được đó là gì, và tốt nhất không nên nhắc lại con số này như một kết quả của bài báo.
Các công trình sau đó, như EgoScale, dẫn EgoMimic như nghiên cứu trước về mở rộng quy mô học bắt chước bằng dữ liệu người ở góc nhìn thứ nhất, đồng thời định vị đóng góp của mình ở các quy luật mở rộng quy mô và lượng dữ liệu lớn hơn.
Tóm tắt bài báo: https://arxiv.org/abs/2410.24221
Bản PDF bài báo: https://arxiv.org/pdf/2410.24221
Trang dự án: https://egomimic.github.io/
Bài blog của Meta: https://ai.meta.com/blog/egomimic-project-aria-georgia-tech-ego4d-robotics-embodied-ai/
Kho mã nguồn: https://github.com/SimarKareer/EgoMimic
Kotwel là đối tác về chất lượng và vận hành dữ liệu cho AI Vật lý (Physical AI). Chúng tôi chuyển đổi dữ liệu đa phương thức từ thế giới thực và dữ liệu tổng hợp thành các bộ dữ liệu được đồng bộ, cấu trúc hóa, kiểm định chất lượng và có khả năng truy xuất nguồn gốc, phục vụ việc huấn luyện, đánh giá và cải tiến liên tục. Chúng tôi xác định rõ các quy ước và lựa chọn có ảnh hưởng đến chất lượng dữ liệu, đồng thời xây dựng các tiêu chí chất lượng có thể đo lường, làm cơ sở để các tổ chức đánh giá và cải thiện dữ liệu cho các hệ thống AI Vật lý.
Kotwel tập trung vào tầng dữ liệu, không phụ thuộc vào một nền tảng phần cứng, hệ thống cảm biến hay dòng mô hình AI cụ thể nào. Chúng tôi xây dựng tiêu chí chất lượng, kiểm tra dữ liệu và đánh giá mức độ đáp ứng các yêu cầu đã thống nhất. Khách hàng quyết định các quy ước riêng của dự án, hành vi mong muốn của mô hình và yêu cầu vận hành, miễn là các yêu cầu này được ghi rõ và áp dụng nhất quán. Kotwel không chế tạo robot, phát triển hệ thống tự hành hoặc điều khiển, hay huấn luyện mô hình nền tảng. Các quyết định về an toàn, pháp lý và triển khai hệ thống thuộc trách nhiệm của khách hàng.
Dữ liệu người của EgoMimic không có trạng thái kẹp, nên thao tác nắm bắt chỉ được giám sát bằng dữ liệu robot. Khi mở rộng định dạng này, nhóm thực hiện phải chọn một cách đặc tả mà bài báo chưa thử nghiệm. Một cách là suy ra tín hiệu nắm bắt nhị phân từ tư thế ngón tay và dùng tín hiệu đó để giám sát phía dữ liệu người. Cách này có nguy cơ dạy chính sách một ngưỡng khép thuộc về bàn tay người, thay vì bộ kẹp. Cách còn lại là để dữ liệu robot đảm nhiệm toàn bộ tín hiệu nắm bắt. Điều này giữ tín hiệu người không lẫn thông tin nắm bắt suy diễn, nhưng khiến chính giai đoạn xuất hiện trong ví dụ thất bại của bài báo — nắm quai túi — vẫn chỉ được giám sát bằng dữ liệu robot. Kotwel đưa lựa chọn này ra để nhóm phụ trách chính sách quyết định trước khi bắt đầu gán nhãn, và không thay họ quyết định định nghĩa thao tác nắm bắt.
EgoMimic huấn luyện chung một chính sách trên dữ liệu bàn tay người ở góc nhìn thứ nhất và dữ liệu robot điều khiển từ xa, đồng thời báo cáo mức cải thiện so với mô hình cơ sở dự đoán chuỗi hành động trên ba tác vụ thực tế.
Mức tăng điểm tương đối được báo cáo so với mô hình cơ sở đó là 34 đến 228%. Nhận định về mở rộng quy mô dựa trên một tác vụ với một cách phối trộn dữ liệu.
Chưa tìm thấy căn cứ trong văn bản bài báo cho các con số 400% và 90 phút mà Meta nêu khi giới thiệu công trình.
Dữ liệu người trong quy trình này chứa tư thế bàn tay do máy ước lượng và không có tín hiệu nắm bắt. Vì vậy, chất lượng theo dõi và cách định nghĩa thao tác nắm bắt vẫn là những vấn đề dữ liệu cần làm rõ.
Trong bài báo này, ở tác vụ đặt vật vào bát, 2 giờ dữ liệu robot cộng 1 giờ dữ liệu bàn tay đạt 128 điểm, so với 74 điểm của mô hình cơ sở được huấn luyện với 3 giờ dữ liệu robot. Các tác giả lưu ý rằng một phần chênh lệch đến từ kiến trúc. Phép so sánh chỉ bao gồm một tác vụ và một cách phối trộn dữ liệu, nên đây là kết quả đo trong những điều kiện đó, không phải tỷ lệ quy đổi giữa hai nguồn dữ liệu.
Bài blog của Meta nói như vậy, nhưng nội dung bài báo được đọc để viết ghi chú này báo cáo mức cải thiện điểm tương đối lớn nhất là 228% so với mô hình cơ sở dự đoán chuỗi hành động, ở tác vụ đặt vật vào bát. Ghi chú này không truy được con số 400% về một quy trình thí nghiệm trong bài báo.
Hệ thống trong bài báo dùng kính này để theo dõi bàn tay, ước lượng tư thế thiết bị và làm camera chính của robot. Bài báo không thử nghiệm thiết bị thu dữ liệu khác, nên chưa biết phương pháp có áp dụng được với những thiết bị đó hay không.